
JEV یک مدل هوش مصنوعی از TypeSafe AI است که بهجای تولید متن، برای گرفتن تصمیمهای سریع، ساختاریافته و قابل استفاده توسط نرمافزار طراحی شده است.
JEV چیست؟
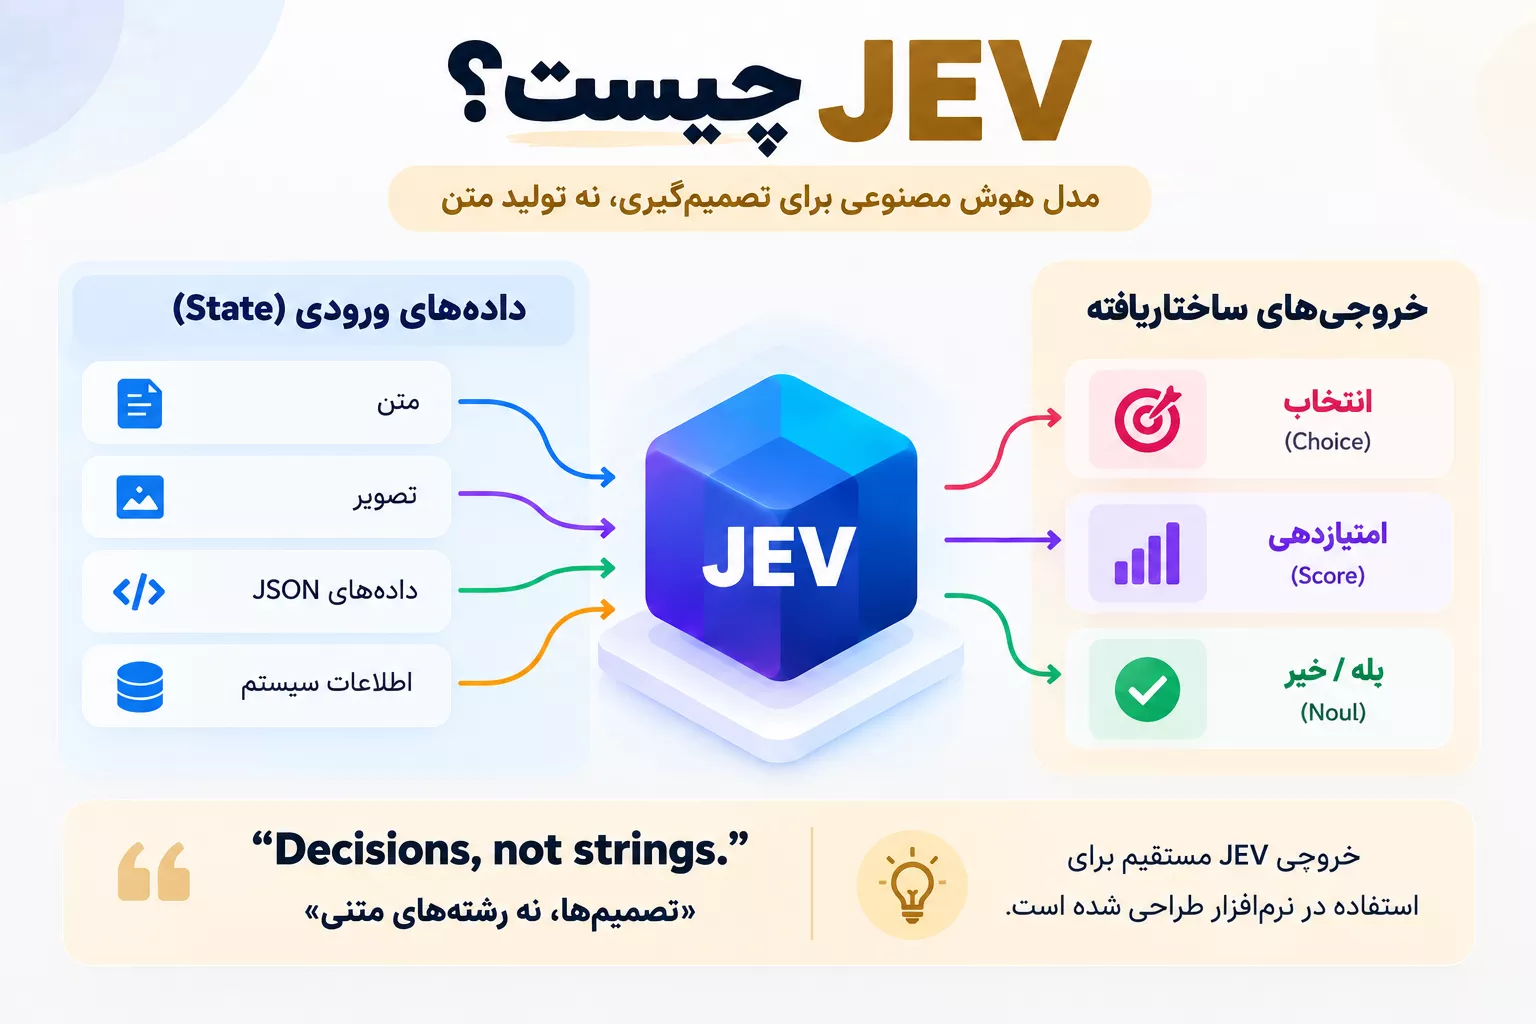
بیشتر مدلهای هوش مصنوعی که امروزه استفاده میکنیم، برای تولید متن ساخته شدهاند. کاربر سؤال میپرسد و مدل پاسخ متنی تولید میکند؛ یا یک سند در اختیار مدل قرار میگیرد و مدل آن را خلاصه میکند.
اما بسیاری از نرمافزارها به متن جدید نیاز ندارند. آنها فقط به یک تصمیم نیاز دارند. برای مثال:
- این درخواست باید به بخش مالی ارسال شود یا پشتیبانی فنی؟
- آیا این سند حاوی اطلاعات شناساییکننده شخصی است؟
- میزان ارتباط این متن با یک عبارت جستوجو چقدر است؟
- آیا این تراکنش به اندازهای مشکوک است که به بررسی بیشتر نیاز داشته باشد؟
مقالهی Towards Data Science دقیقاً روی همین تفاوت تمرکز میکند و توضیح میدهد که مسئله اصلی JEV، تبدیل ورودی به یک تصمیم قابل استفاده برای نرمافزار است.
«Decisions, not strings.»
«تصمیم بگیر، نه اینکه متن تولید کنی.»
JEV نخستین System One Model شرکت TypeSafe است؛ مدلی که برای تصمیمگیری سریع و ساختاریافته طراحی شده و خروجی آن بهطور مستقیم میتواند توسط نرمافزار مصرف شود.


JEV چه مشکلی را حل میکند؟
یک مدل زبانی معمولی میتواند یک تصمیم ساده را هم انجام دهد. برای مثال، فرض کنید یک تیکت پشتیبانی چنین متنی دارد:
«برای اشتراک من دو بار هزینه کم شده است. آیا میتوانید مبلغ پرداختی اضافی را برگردانید؟»
نرمافزار میتواند از یک LLM بخواهد این درخواست را در یکی از سه گروه زیر قرار دهد:
- billing
- technical
- sales
در حالت ایدهآل، مدل فقط یکی از این سه گزینه را برمیگرداند.
اما مدلهای مولد اساساً برای تولید دنبالهای از کلمات ساخته شدهاند. بنابراین ممکن است بهجای فقط billing، توضیح اضافه بدهند، قالب مورد انتظار را رعایت نکنند یا حتی خروجی نامعتبر تولید کنند.
در چنین حالتی، نرمافزار مجبور است خروجی مدل را دریافت، تجزیه و بررسی کند تا بتواند از آن در برنامه استفاده کند.
JEV این مسئله را از مسیر دیگری حل میکند: فضای خروجی از قبل مشخص میشود.
اگر سه گزینهی billing، technical و sales تعریف شده باشند، JEV قرار نیست یک جمله تولید کند و بعد برنامه از داخل آن جمله کلمه موردنظر را استخراج کند. مدل مستقیماً از میان گزینههای تعریفشده تصمیم میگیرد.
بنابراین خروجی نمیتواند یک دستهبندی جدید یا توضیح اضافی خارج از ساختار تعیینشده باشد.
JEV چگونه کار میکند؟
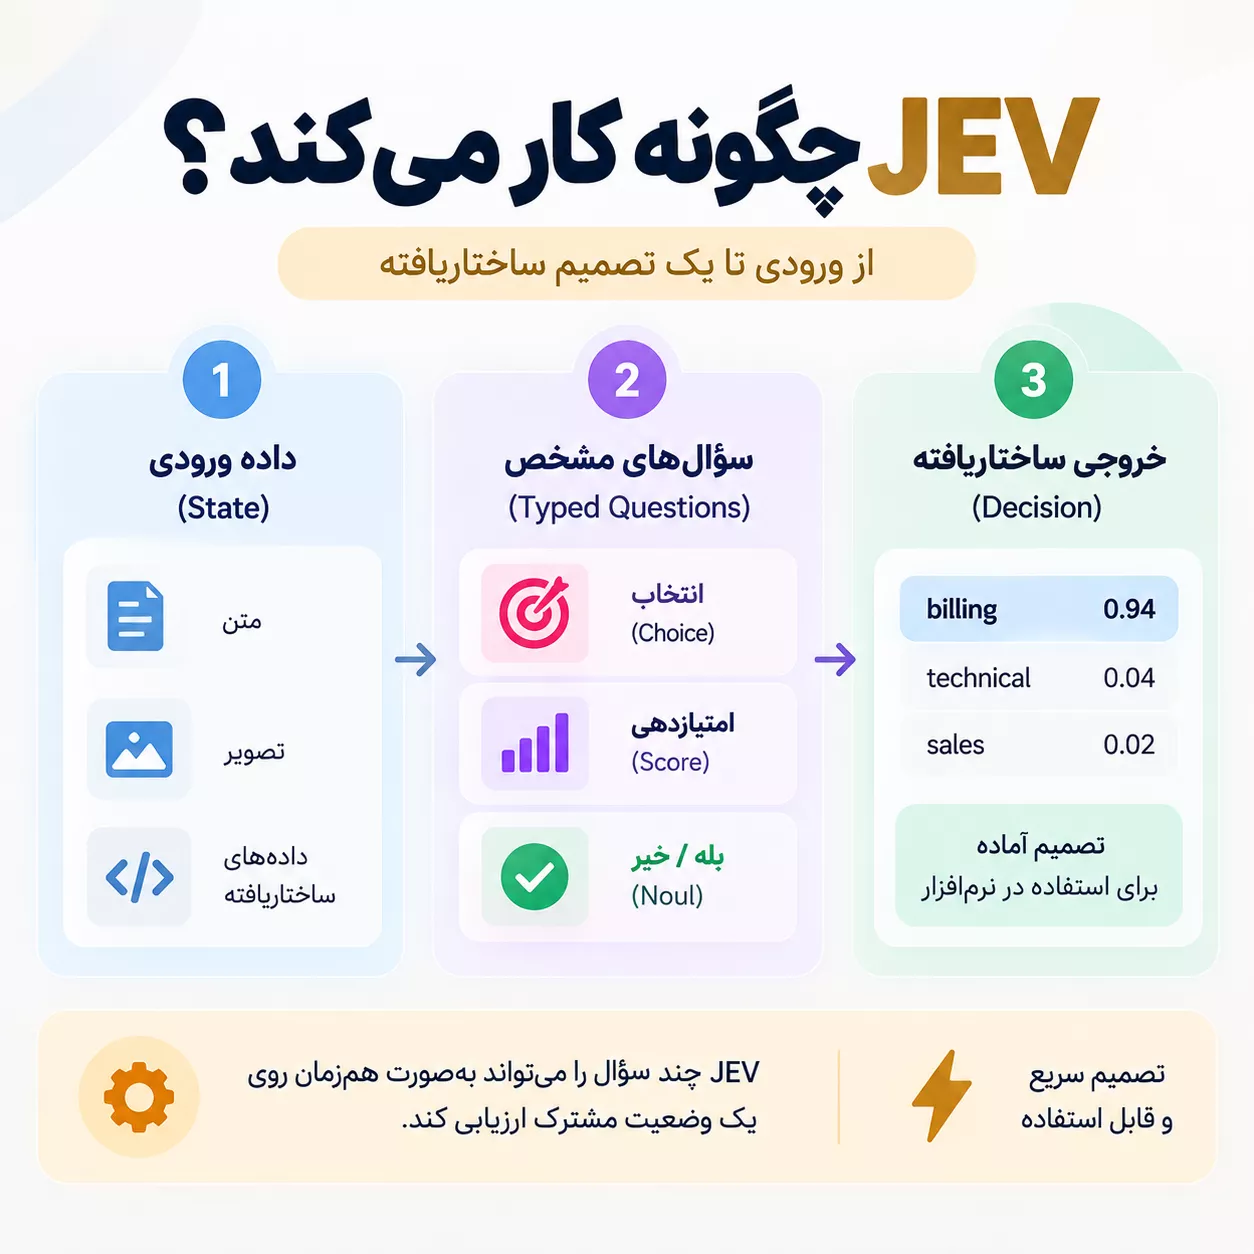
نحوه کار JEV را میتوان در دو بخش اصلی خلاصه کرد:
- State یا وضعیت ورودی
- Typed Questions یا پرسشهای دارای نوع مشخص
ورودی یا وضعیت وارد مدل میشود و JEV آن را در برابر یک یا چند سؤال از پیش تعریفشده ارزیابی میکند و در نهایت یک تصمیم ساختاریافته همراه با میزان اطمینان ارائه میدهد.
State چیست؟
State همان اطلاعاتی است که JEV باید درباره آن تصمیم بگیرد.
این اطلاعات میتواند شامل موارد مختلفی باشد، مانند:
- متن پیام یک مشتری
- یک شیء JSON
- اطلاعات یک سفارش
- دادههای یک سیستم
- اطلاعات مربوط به یک وضعیت مشخص
بنابراین JEV ابتدا دادهای را که قرار است درباره آن تصمیم گرفته شود دریافت میکند.
Typed Question چیست؟
بعد از دریافت State، یک یا چند سؤال مشخص برای مدل تعریف میشود.
نکته مهم این است که نوع خروجی نیز از قبل مشخص شده است. یعنی برنامهنویس تعیین میکند که پاسخ باید چه ساختاری داشته باشد.
برای مثال، سؤال میتواند از مدل بخواهد:
- یک گزینه را انتخاب کند؛
- یک مقدار را روی یک مقیاس قرار دهد؛
- احتمال درست بودن یک گزاره را مشخص کند.
به همین دلیل، خروجی JEV مانند پاسخ آزاد یک مدل زبانی نیست.
سه نوع تصمیم در JEV
در حال حاضر JEV تصمیمهای خود را در سه primitive اصلی ارائه میکند:
- Choice
- Score
- Noul
هرکدام برای نوع متفاوتی از تصمیمگیری استفاده میشوند.
Choice چیست؟
Choice زمانی استفاده میشود که چند گزینه مشخص داریم و میخواهیم JEV یکی از آنها را انتخاب کند.
برای مثال، یک تیکت پشتیبانی میتواند یکی از این سه دسته باشد:
- billing
- technical
- sales
در این حالت، JEV فقط از میان گزینههایی که از قبل تعریف شدهاند انتخاب میکند.
نکته مهمتر این است که خروجی فقط یک برچسب نیست. JEV میتواند احتمال مربوط به گزینههای مختلف را نیز ارائه کند.
برای نمونه، نتیجه فرضی میتواند چنین باشد:
billing       0.94
technical     0.04
sales         0.02
در این مثال، نرمافزار میتواند بر اساس این میزان اطمینان تصمیم بگیرد که درخواست را مستقیماً ارسال کند یا برای بررسی انسانی بفرستد.
Score چیست؟
گاهی هدف انتخاب یک دسته جدا از دستههای دیگر نیست، بلکه میخواهیم یک مفهوم را روی یک مقیاس دارای ترتیب قرار دهیم.
برای مثال، میزان فوریت یک پیام را میتوان به شکل زیر تعریف کرد:
- عادی
- نسبتاً فوری
- فوری
- بحرانی
در این حالت از Score استفاده میشود.
مقالهی Towards Data Science نمونههایی مانند موارد زیر را برای چنین مقیاسهایی مطرح میکند:
- میزان نارضایتی مشتری
- میزان ارتباط یک سند
- ریسک
- شدت
- کیفیت
- اولویت
نکته مهم این است که معنی مقیاس از قبل توسط برنامهنویس مشخص میشود و JEV ورودی را بر اساس همان تعریف ارزیابی میکند.
Noul چیست؟
Noul برای یک گزارهی بله/خیر استفاده میشود و احتمال درست بودن آن گزاره را برمیگرداند.
برای مثال:
آیا این متن حاوی اطلاعات شناساییکننده شخصی است؟
اگر خروجی نزدیک به 1.0 باشد، یعنی شواهد قوی به نفع درست بودن گزاره وجود دارد.
اگر خروجی نزدیک به 0.0 باشد، یعنی شواهد قوی به نفع نادرست بودن گزاره وجود دارد.
مقدار 0.5 نیز نشاندهنده عدم اطمینان بالاتر است و تقریباً به این معناست که احتمال درست یا نادرست بودن گزاره برابر است.
تفاوت JEV با یک LLM معمولی چیست؟
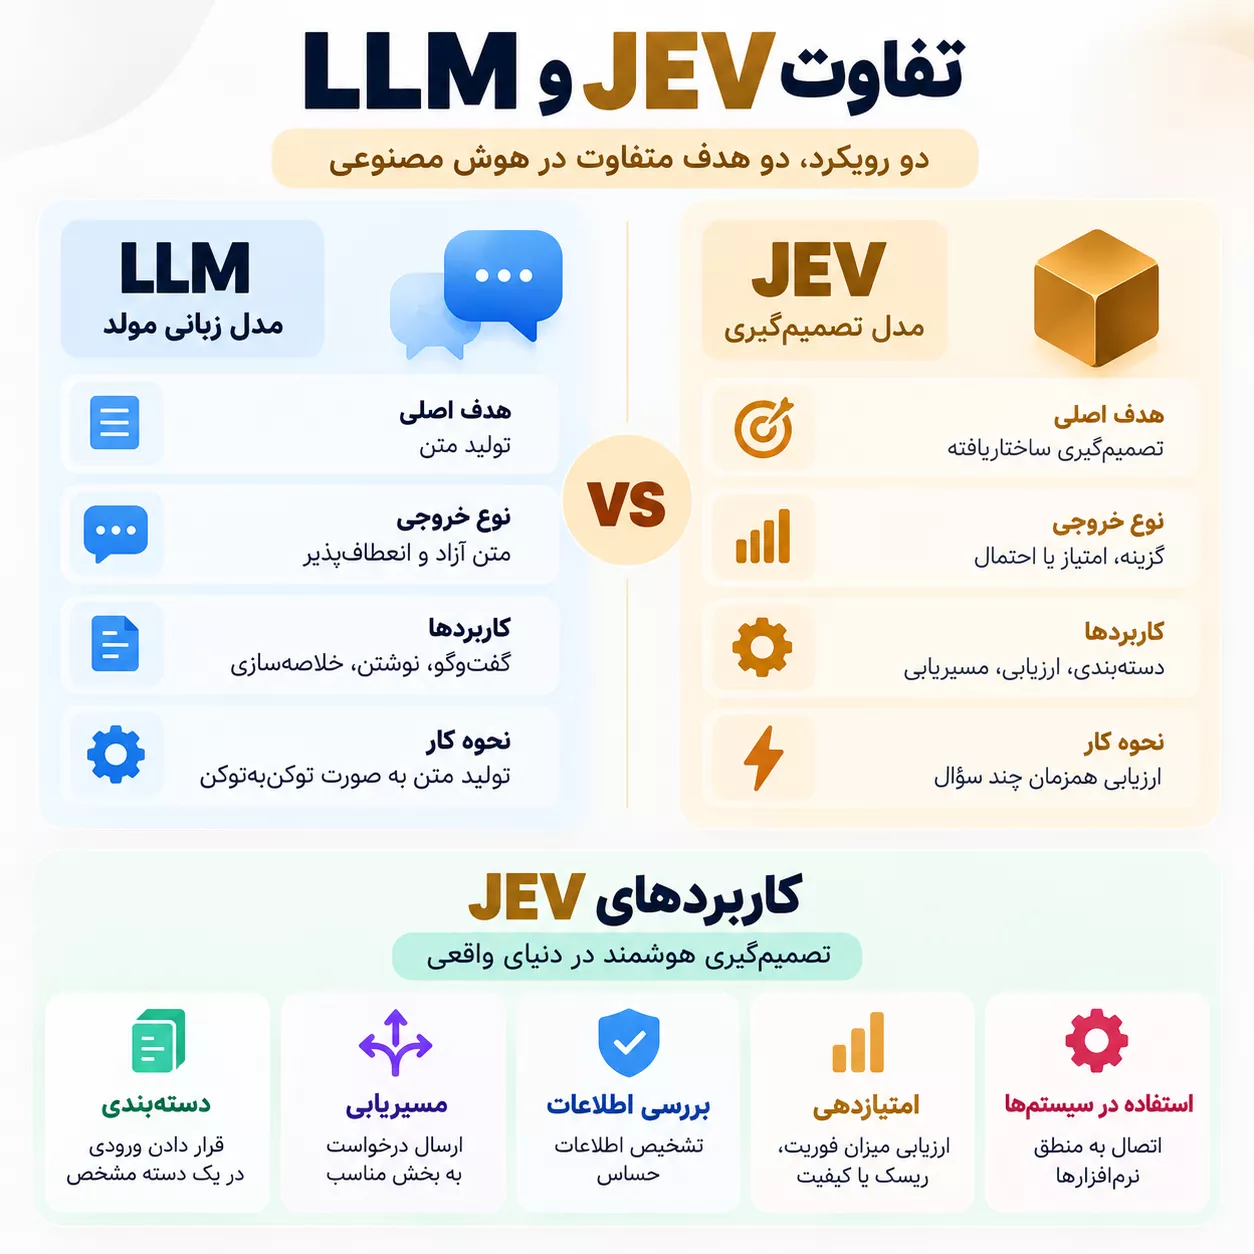
تفاوت اصلی در نوع کاری است که مدل برای انجام آن طراحی شده است.
یک LLM معمولی برای تولید متن آزاد ساخته شده است. مدل میتواند مقاله بنویسد، پاسخ توضیحی بدهد، کد تولید کند یا یک سند را خلاصه کند.
JEV برای این نوع کارها طراحی نشده است.
این تفاوت با مقایسهی System One و مدلهای متداول توضیح داده میشود. JEV برای قضاوتهای سریع و مشخص طراحی شده، در حالی که مدلهای زبانی معمولی برای کارهایی که به تولید و پردازش زبان نیاز دارند مناسبتر هستند.
Global Tech Council نیز تأکید میکند که JEV بهجای تولید متن بهصورت token-by-token، وضعیت ورودی را بررسی کرده و یک پاسخ ساختاریافته برمیگرداند.
System One Model در JEV یعنی چه؟
TypeSafe مدل JEV را یک System One Model معرفی میکند.
این نام از مفهوم معروف System 1 و System 2 در کتاب Thinking, Fast and Slow اثر دنیل کانمن گرفته شده است. System 1 به نوعی از تصمیمگیری سریع و خودکار اشاره دارد، در حالی که System 2 برای تصمیمگیری آهستهتر و آگاهانهتر به کار میرود.
JEV برای نوع اول طراحی شده است: یعنی دریافت یک وضعیت مشخص، پاسخ دادن به یک سؤال مشخص و ارائه یک تصمیم سریع. بنابراین هدف JEV این نیست که مانند یک مدل گفتوگومحور ساعتها درباره یک مسئله استدلال کند یا یک مقاله طولانی بنویسد.
معماری JEV چگونه باعث سرعت آن میشود؟
یکی از تفاوتهای مهم JEV با مدلهای زبانی معمولی، نحوه پردازش درخواست است.
مدلهای زبانی معمولی از autoregressive generation استفاده میکنند؛ یعنی خروجی را بهصورت توکنبهتوکن تولید میکنند و هر بخش از خروجی به بخشهای قبلی وابسته است.
JEV رویکرد متفاوتی دارد. JEV از یک hardware-aware parallel sampler استفاده میکند و پرسشهای مختلف را بهصورت همزمان روی یک State مشترک ارزیابی میکند. این فرایند در یک forward pass انجام میشود.
به همین دلیل، در یک درخواست میتوان چند سؤال را بهصورت موازی مطرح کرد، بدون اینکه لازم باشد برای هر سؤال یک فراخوانی کاملاً جداگانه انجام شود.
چرا خروجی JEV ساختاریافته است؟
در JEV، شکل خروجی قبل از پردازش سؤال مشخص میشود. برای مثال اگر نوع سؤال Choice باشد، گزینههای قابل انتخاب از قبل تعریف شدهاند. بنابراین مدل نمیتواند چیزی خارج از آن ساختار تولید کند.
این تفاوت مهمی با حالتی دارد که از یک LLM بخواهیم:
«فقط یک JSON معتبر برگردان.»
در حالت دوم، مدل همچنان در حال تولید متن است و باید مطمئن شویم متن تولیدشده با ساختار موردنظر مطابقت دارد. در JEV، ساختار پاسخ بخشی از خود درخواست است.
به همین دلیل، JEV نمیتواند مقداری خارج از schema از پیش تعریفشده برگرداند. البته این به معنای مصون بودن مدل از تصمیم اشتباه نیست؛ مدل میتواند در همان محدوده تعریفشده، قضاوت نادرستی داشته باشد.
JEV چه نوع خروجیای ارائه میدهد؟
خروجی JEV میتواند بسته به نوع سؤال متفاوت باشد.
-
Choice
انتخاب یکی از گزینههای از پیش تعریفشده.
-
Score
قرار دادن ورودی در یک مقیاس مشخص و دارای ترتیب.
-
Noul
ارائه احتمال درست بودن یک گزاره بله/خیر.
بنابراین خروجی JEV چیزی است که نرمافزار میتواند مستقیماً از آن استفاده کند.
بهجای اینکه برنامه مجبور باشد از یک پاراگراف تولیدشده توسط AI اطلاعات استخراج کند، نتیجه از ابتدا در قالبی قرار دارد که برای استفاده ماشینی تعریف شده است.
یک مثال عملی از کاربرد JEV
مقالهی Towards Data Science یک نمونه عملی برای بررسی فایلها ارائه میکند.
فرض کنید نرمافزاری داریم که باید قبل از پردازش یک فایل مشخص کند:
- فایل چه نوعی است؟
- آیا اطلاعات پزشکی دارد؟
- آیا اطلاعات شناسایی شخصی دارد؟
- آیا شامل اطلاعات محرمانه یا اطلاعات دسترسی است؟
در چنین سیستمی، میتوان از Choice برای تشخیص نوع فایل استفاده کرد و سپس چند سؤال Noul را بهصورت مستقل درباره محتوای فایل مطرح کرد.
برای مثال:
- آیا فایل شامل اطلاعات پزشکی است؟
- آیا شامل اطلاعات شخصی قابل شناسایی است؟
- آیا شامل API Key یا اطلاعات احراز هویت است؟
- آیا شامل اطلاعات محرمانه دیگری است؟
در آزمایش ارائهشده در مقاله، JEV برای یک فایل آزمایشی حاوی اطلاعات حساس، احتمالهای بالایی برای چند دسته مختلف برگرداند. برای نمونه، احتمال مربوط به اطلاعات پزشکی
0.99، اطلاعات شناسایی شخصی0.98و اطلاعات مربوط به credentials برابر0.93گزارش شد.منبع: Towards Data Science
در ادامه، همان مقاله یک فایل عمومی و غیرحساس را نیز آزمایش میکند که در آن احتمالهای مربوط به دستههای حساس بسیار پایینتر گزارش شدند.
نکته مهم این مثال این است که JEV خودش تصمیم عملیاتی نهایی را اجرا نمیکند.
JEV میتواند بگوید احتمال وجود PII مثلاً 0.97 است؛ سپس این کد نرمافزار است که تصمیم میگیرد فایل را مسدود کند، برای بررسی انسانی بفرستد یا اجازه پردازش بدهد.
به بیان ساده:
JEV قضاوت معنایی را انجام میدهد؛ نرمافزار تصمیم عملیاتی را اجرا میکند.
سرعت JEV چقدر است؟
فرایند JEV معمولاً حدود ۷۰ تا ۵۰۰ میلیثانیه طول میکشد. این سرعت به معماری موازی آن و کنار گذاشتن تولید متوالی متن نسبت داده شده است.
این موضوع مخصوصاً برای نرمافزارهایی اهمیت دارد که باید تعداد زیادی تصمیم کوچک را در زمان کوتاه بگیرند.
در چنین شرایطی، استفاده از یک مدل مولد بزرگ برای هر تصمیم میتواند از نظر زمان و هزینه منطقی نباشد.
JEV برای چه کارهایی مناسب است؟
کاربرد اصلی JEV در موقعیتهایی است که نرمافزار به یک تصمیم مشخص نیاز دارد، نه یک متن طولانی.
نمونهها عبارتاند از:
- دستهبندی درخواستها
- مسیریابی درخواستها به بخش مناسب
- ارزیابی ریسک
- تشخیص وجود اطلاعات حساس
- امتیازدهی
- بررسی یک شرط مشخص
- نظارت بر وضعیتهای مختلف نرمافزاری
مقالهی Towards Data Science این مفهوم را به یک «smart if-statement» تشبیه میکند؛ یعنی JEV میتواند شرطهای معنایی و مبهمی را ارزیابی کند که تعریف آنها با قواعد سنتی برنامهنویسی دشوار است.
JEV چه کارهایی را نمیتواند انجام دهد؟
JEV برای تولید آزادانه محتوا طراحی نشده است.
بنابراین کارهایی مانند موارد زیر در محدوده اصلی طراحی آن قرار نمیگیرند:
- نوشتن مقاله
- گفتوگوی طولانی و پیچیده
- خلاصهکردن یک سند طولانی
- تولید محتوای خلاقانه
- پاسخگویی آزاد به سؤالات بدون ساختار مشخص
دلیل این محدودیت، ضعف تصادفی مدل نیست؛ بلکه هدف طراحی آن متفاوت است. JEV برای پاسخ دادن به سؤالهای محدود و از پیش تعریفشده ساخته شده است.
آیا JEV جایگزین مدلهای زبانی میشود؟
بر اساس مطالب پیشین JEV قرار نیست جایگزین مستقیم مدلهای زبانی مولد باشد. مدلهای زبانی برای تولید زبان، گفتوگو، نوشتن و کارهای باز و انعطافپذیر کاربرد دارند. JEV مسئله متفاوتی را هدف گرفته است: تصمیمگیری سریع و ساختاریافته برای نرمافزار.
بنابراین میتوان این دو نوع مدل را بهعنوان اجزای متفاوت یک سیستم در نظر گرفت:
- LLM → تولید و پردازش زبان
- JEV → تصمیم ساختاریافته
این تفاوت باعث میشود سؤال اصلی درباره JEV این نباشد که «آیا از LLM بهتر است؟»، بلکه این باشد که آیا مسئلهای که داریم واقعاً به تولید متن نیاز دارد یا فقط به یک تصمیم مشخص؟
جمعبندی
JEV یک مدل هوش مصنوعی از TypeSafe AI است که برای تصمیمگیری سریع و ساختاریافته طراحی شده است، نه تولید متن آزاد.
فرایند آن را میتوان به شکل زیر خلاصه کرد:
State → Typed Question → Structured Decision
یعنی ابتدا وضعیت یا داده موردنظر وارد میشود، سپس یک یا چند سؤال دارای نوع مشخص روی آن اعمال میشود و در نهایت تصمیمی ساختاریافته همراه با احتمال یا میزان اطمینان برگردانده میشود.
سه primitive اصلی JEV عبارتاند از:
- Choice: انتخاب از میان گزینههای مشخص
- Score: قرار دادن ورودی روی یک مقیاس دارای ترتیب
- Noul: تعیین احتمال درست بودن یک گزاره بله/خیر
مهمترین تفاوت JEV با مدلهای زبانی مولد نیز این است که JEV برای تولید یک رشته متن آزاد تلاش نمیکند. فضای خروجی از قبل تعریف شده و نتیجه مستقیماً برای استفاده نرمافزار آماده است.
همانطور که مقالهی Towards Data Science در پایان توضیح میدهد، ایده اصلی JEV این است که وقتی طرف مقابل انسان نیست و برنامه دیگر است، شاید خروجی مناسب AI دیگر یک پاراگراف نباشد، بلکه تصمیمی ساختاریافته باشد.
منابع مقاله:
- Towards Data Science، An Introduction to Jev
-
Global Tech Council، What Is Jev and How Does It Work



دیدگاههای همراهان نوین
کامنت شما داره ارسال میشه…
0%
لطفاً چند لحظه صبر کنید
ارسال شد! ✨
دیدگاه شما ثبت شد. ممنون از همراهیتون.
ارسال انجام نشد